Vue d'ensemble
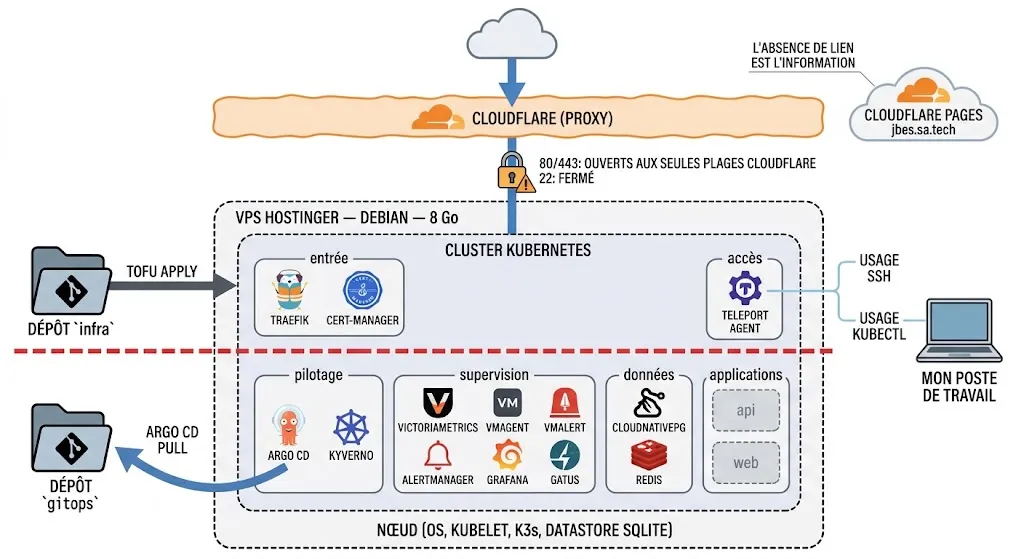
La plateforme tient sur une seule machine. Un VPS Hostinger, 8 Go de RAM, Debian. Dessus, un cluster K3s à un nœud fait tourner l’ingress, les bases de données, la supervision et les applications.
Tout ce qui définit cette machine et ce cluster est écrit dans deux dépôts Git. Rien n’est configuré à la main, à une exception près, décrite plus bas.
Une machine, un nœud
Section intitulée « Une machine, un nœud »Le serveur est créé par OpenTofu, avec le provider Hostinger. Le provider Cloudflare gère en parallèle la zone DNS et les réglages du proxy.
L’état OpenTofu est aujourd’hui un fichier local, sur mon poste. Le bloc de backend distant est
écrit dans versions.tf et mis en commentaire, en attente du stockage objet prévu.
C’est le point le plus fragile de la chaîne. Ce fichier est la correspondance entre le code et les ressources réelles — l’identifiant de la machine, ceux des enregistrements DNS. Le perdre ne casse rien en production, mais OpenTofu ne sait alors plus ce qu’il gère : il faut réimporter chaque ressource à la main. Et tant qu’il est local, je suis le seul à pouvoir appliquer. La décision 01 revient dessus.
Le durcissement et la configuration du nœud sont faits par un script post-installation, passé à la machine au moment de sa création. C’est lui qui installe K3s. Entre la commande de création et un cluster qui répond, il n’y a aucune connexion manuelle.
Le cycle complet — création, destruction, recréation — a été exécuté et vérifié. C’est l’engagement de cette plateforme : elle se reconstruit. Ce n’est pas le même engagement que la disponibilité, et la décision 02 explique pourquoi.
Une nuance sur cette reconstructibilité. La machine est facturée à l’année, payée d’avance. Détruire et recréer le serveur ne coûte rien de plus. Faire tourner un second environnement en parallèle, si. L’infrastructure est reconstructible ; elle n’est pas jetable au sens économique.
K3s, volontairement nu
Section intitulée « K3s, volontairement nu »K3s est installé en mono-nœud, avec trois choix faits dès l’installation.
Traefik désactivé. K3s embarque Traefik et l’installe par défaut. Il est désactivé pour que Traefik soit déployé par ArgoCD comme le reste, avec sa version et ses valeurs Helm lisibles dans Git. Un composant installé par l’installeur de K3s échappe au GitOps, et devient le seul endroit où il faut se souvenir d’aller regarder.
Chiffrement des Secrets au repos. Le datastore de K3s est une base SQLite : etcd n’est pas activé, il n’apporterait rien sur un nœud unique. Les Secrets y sont chiffrés. Un fichier de base récupéré sur le disque ne livre pas les mots de passe en clair.
Réservations kubelet. Une part de la CPU et de la mémoire est réservée au système et au kubelet. Sur une machine à 8 Go, un pod qui dérape peut rendre le nœud injoignable — y compris pour s’y connecter et comprendre. La réservation garde de quoi diagnostiquer.
Deux propriétaires, une frontière
Section intitulée « Deux propriétaires, une frontière »Deux outils écrivent l’état, et ils ne se recouvrent pas.
OpenTofu possède ce qui est sous Kubernetes : la machine, le pare-feu, la zone DNS, les réglages Cloudflare.
ArgoCD possède ce qui est dans Kubernetes : Namespaces, Deployments, Services, Ingress, CRD, politiques d’admission.
La frontière est le point où K3s répond. En dessous, tofu apply. Au-dessus, un commit sur
gitops. Après l’amorçage, aucun kubectl apply n’est exécuté à la main.
Il n’y a pas de troisième outil entre les deux. La décision 03 explique pourquoi Ansible a été écarté.
Cinq dépôts
Section intitulée « Cinq dépôts »| Dépôt | Contenu | Qui l’applique |
|---|---|---|
infra |
OpenTofu : machine, pare-feu, DNS, Cloudflare | tofu apply |
gitops |
Helm, Kustomize, Applications ArgoCD | ArgoCD |
api |
API Laravel | GitHub Actions construit, ArgoCD déploie |
web |
Interface Nuxt | GitHub Actions construit, ArgoCD déploie |
docs |
Ce site | Cloudflare Pages |
api et web sont en cours d’écriture. Leurs Ingress sont déjà déclarés dans gitops :
api.jbessa.tech et app.jbessa.tech sont routés, les Deployments derrière sont à venir. Tout
le reste de ce site décrit des composants en production.
Le trajet d’une requête
Section intitulée « Le trajet d’une requête »- Le client résout
app.jbessa.tech. Cloudflare répond, en proxy — l’adresse du serveur n’est pas publiée. - Cloudflare ouvre la connexion vers l’IP du serveur, sur 443.
- Le pare-feu n’accepte 80 et 443 que depuis les plages d’adresses publiées par Cloudflare. Une requête qui vise l’IP directement est rejetée avant d’atteindre Traefik.
- Traefik termine TLS et route vers le Service, d’après l’Ingress.
- Le certificat est émis par cert-manager via un challenge DNS-01 sur la zone Cloudflare. DNS-01 prouve la possession du domaine sans exposer de point d’entrée HTTP, et permet les certificats wildcard.
Il n’y a pas d’autre chemin d’entrée.
Comment j’entre
Section intitulée « Comment j’entre »L’accès administratif passe par Teleport Community Edition : SSH et kubectl derrière une seule
identité, des certificats de courte durée au lieu de clés durables, et l’enregistrement des
sessions.
Le port 22 est fermé en permanence, pas seulement filtré. Il n’y a pas de clé SSH à révoquer si un poste est perdu — les certificats expirent seuls.
La décision 05 donne le coût de ce choix, dont une étape d’installation restée manuelle.
Ce site est hors du cluster
Section intitulée « Ce site est hors du cluster »jbessa.tech est un site statique servi par Cloudflare Pages. Il ne tourne pas sur la plateforme
qu’il décrit, et c’est délibéré.
La documentation d’une plateforme doit rester lisible quand la plateforme est arrêtée. Le runbook de restauration est sur ce site. Hébergé sur la machine qu’il sert à réparer, il serait inaccessible au moment précis où j’en ai besoin.
Conséquence : les indicateurs en direct prévus sur la page d’accueil devront être récupérés par appel réseau depuis l’extérieur, comme n’importe quel visiteur. Ce site n’a aucun accès privilégié au cluster.
La contrainte : 8 Go
Section intitulée « La contrainte : 8 Go »Tout ce qui précède est contraint par une seule ligne de facture.
Ces 8 Go ne sont pas un budget applicatif. Il faut d’abord en retirer le système Debian et le kubelet, protégés par les réservations, puis le plan de contrôle K3s et son datastore, puis Traefik, cert-manager et ArgoCD, puis Teleport — environ 200 Mo — puis la supervision, puis PostgreSQL et Redis. Ce qui reste va aux applications.
Ce qui reste est petit. C’est la raison de la plupart des décisions documentées sur ce site :
- VictoriaMetrics plutôt que la pile Prometheus complète :
kube-prometheus-stackpèse 1,5 à 2 Go, la même function tient dans un quart (décision 04) ; - un seul réplica par application, donc une interruption courte à chaque déploiement (décision 02) ;
- KEDA plafonné à 4 réplicas de worker : au-delà, la mémoire manquerait à PostgreSQL et à la supervision ;
- une seule instance PostgreSQL ;
- aucune collecte centralisée des journaux : l’indexation et le stockage consommeraient ce qui reste. C’est le manque le plus sérieux de la plateforme, détaillé dans Exploitation et observabilité.
Quand un choix décrit ici paraît minimal, la raison est presque toujours celle-là. Le détail des arbitrages est dans les décisions.